pi 的变迁:从 No MCP 到 MCP+Codemode
一、起因
pi 昨天(2026-09-29)发布了 0.99.0,changelog 新功能的第一条是 “Codemode and MCP”:可以连接 MCP server,模型可以写 JavaScript 并行调用工具。同一个版本里还有 tool_search,以及在 codemode 里调用 TypeSafe 的分类模型 Jev。
 GitHub
pi.dev 首页原来有一张卡片写着 “No MCP”,现在这几个字加了删除线,下面换成 “Now with MCP+Codemode”。
这让我有点意外。Mario 一直不喜欢 MCP,去年 11 月介绍 pi 的那篇文章里专门有一节 “No MCP support”,第一句是 “pi does not and will not support MCP.”
 What I learned building an opinionated and minimal coding agentLessons I learned while building my own coding agent from scratch.
十个月后,pi 把 MCP 做成了内置扩展。Earendil 为此发了一篇文章,标题就叫 “You Said No MCP!”。这篇解释我第一遍读得不太明白。要弄清楚它为什么改主意,得先回到它当初为什么不要 MCP。
二、Mario 当初反对什么
Mario 写过两篇专门讲 MCP 的文章。
第一篇是 2025 年 8 月的一次 benchmark。他写了一个终端控制工具 terminalcp,同时做成 MCP server 和 CLI 两个版本,再拿 tmux、screen 这两个模型训练时见过的 CLI 做对照,让 Claude Code 跑三个任务:用 LLDB 调试、操作 Python REPL、在 OpenCode 的 TUI 里切换模型。每个组合跑 10 次,一共 120 次。
 MCP vs CLI: Benchmarking Tools for Coding AgentsA data-driven comparison of MCP and CLI approaches for coding agent terminal control
结果 MCP 版和 CLI 版都是 100% 成功,MCP 版快 23%,便宜 2.5%,差得不多。他的结论是协议只是管道,效果取决于工具本身:输出省不省 token,说明写得清不清楚。很多 MCP server 的问题出在设计粗糙,到处返回用不上的 JSON,和协议关系不大。不过他也说,如果从零开始写工具,用户又有 shell 可用,那就写一个好用的 CLI,因为 CLI 的输出可以接管道再过滤,MCP 做不到。
这篇里还有一句后面会用到:他承认有状态的工具用 MCP 写更方便,因为 MCP server 默认就是有状态的。
第二篇是 11 月的 “What if you don’t need MCP at all?”,态度强硬了很多。
 What if you don't need MCP at all?Got Bash and some code interpreter? Skip MCP.
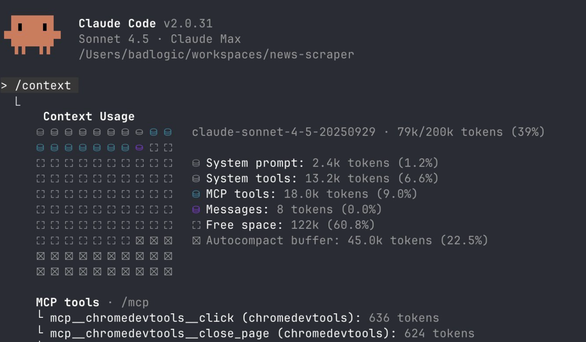
他拿浏览器自动化举例。Playwright MCP 有 21 个工具,定义占 13.7k token,是 Claude 上下文的 6.8%;Chrome DevTools MCP 有 26 个工具,占 18.0k token,9.0%。他自己的做法是写四个 Node 脚本(启动浏览器、导航、执行 JS、截图),配一份 README,需要时让 agent 读 README,再用 bash 调脚本。那份 README 只有 225 token。
文章里对 MCP 的批评可以归成三条:
- 定义占上下文。server 要覆盖所有场景,工具多,描述长,每个会话都要为此付 token;接的 server 多了,工具之间还会互相干扰。
- 结果要经过上下文。MCP 工具的返回值只能先进模型的上下文,模型再决定写进文件还是和别的结果合并。CLI 的输出可以直接重定向、接管道,不经过模型。
- 不好改。想改一个现成 MCP server 的输出格式,得先读懂它的代码;自己写的脚本,让 agent 改一下就行。
pi 文章里 “No MCP support” 那一节基本就是这三条的摘要,最后留了个退路:实在要用 MCP,可以用 Peter Steinberger 的 mcporter 把 MCP server 包成 CLI。
这三条也是我自己用 MCP 时感受最深的。工具一多,定义先占掉一大块上下文;调一次工具,返回的一大段 JSON 又全塞进上下文。后来 Claude Code 的 Tool Search 把第一条缓解了不少,我在上一篇里拆过它的实现。第二条和第三条,Tool Search 管不到。
三、0.99.0 怎么接 MCP
MCP server 写在 ~/.pi/agent/mcp.json 或项目的 .pi/mcp.json 里,格式和 Claude Code、Cursor 的 mcpServers 一样,条目可以直接复制过来。支持 stdio 和 streamable HTTP,支持 OAuth,不支持旧的 SSE 传输。工具统一命名为 mcp__<server>__<tool>。
每个 server 还有一个 exposure 设置,决定模型通过什么方式用到它的工具:
| exposure | 模型看到什么 | 怎么调用 |
|---|---|---|
codemode(默认) | 不声明为工具,只列在 codemode 工具的描述里 | 在 codemode 脚本里调用 |
codemode-deferred | codemode 描述里只写 server 名和工具数 | 脚本里先搜索,再调用 |
deferred | 不声明,tool_search 搜到后才声明 | 搜到后直接调用 |
direct | 和内置工具一样声明 | 直接调用,脚本里也能调 |
hidden | 看不到 | 不能调用 |
toolExposure 可以按工具名单独覆盖,支持通配符。文档里的例子是 GitHub 的 server 整体设为 deferred,search_code 设为 direct,get_* 设为 codemode,delete_* 设为 hidden。
codemode 和 tool_search 这两个工具默认都是关闭的,有对应 exposure 的 server 连上时,pi 才自动打开它们。没接 MCP 也可以在 settings 里写 "defaultTools": ["+codemode"] 单独打开 codemode。
默认值是 codemode,这一点是理解 pi 这次改动的关键:MCP 的工具默认不会作为工具声明给模型。
codemode
用 Earendil 文章里的例子走一遍。任务是找出 issue tracker 里情绪最差的讨论,用到 Linear MCP 的两个工具(列出 issue、列出某个 issue 的评论),再用 Jev 给每个 issue 的讨论判断情绪。
 “You Said No MCP!” | EarendilPi now supports MCP. Why we changed our minds, what changed in MCP and in Pi, and what Codemode is.
如果 Linear 的工具是 direct,模型要先调一次列 issue 的工具,结果进上下文;再对 167 个 open issue 各调一次列评论的工具,167 份评论全部进上下文;最后自己读完判断情绪。上下文放不下,轮数也多。
照 Mario 当初的思路,这种活应该交给代码:模型写一个脚本,用 bash 跑,循环、并发、过滤都在脚本里做,只把汇总打印出来。上下文的问题这样就解决了。但真去写这个脚本,会碰到几个问题。
第一个问题是脚本调不到 Linear 的 MCP 工具。这些工具的连接是 pi 进程建立的,OAuth 的 token 存在 ~/.pi/agent/mcp-auth.json,由 pi 负责刷新。bash 跑的脚本是一个子进程,用不上这些连接。要在脚本里调 Linear,要么再装一个把 MCP 包成命令行的工具,比如 Mario 当初推荐的 mcporter,让它自己连 server、自己再登录一遍;要么绕开 MCP,拿一个 Linear 的 API key 直接调它的 API。Jev 也一样,pi 会话里已经有能用的凭据,脚本却得在环境变量里自己放一份 key。
凭据交给脚本,在隔离环境里就成了问题。Earendil 的文章里说,harness 执行工具有两个地方:bash 运行的地方,通常是一个不太被信任的沙箱;agent 循环运行的地方,通常是可信的。pi 的文档讲隔离运行时提到过一种做法:pi 留在宿主机上,bash 这类内置工具放进一台 micro-VM 执行,凭据留在宿主机上。这时要让 VM 里的脚本调 Linear,就得把 Linear 的 token 放进 VM,这正是隔离想避免的。
第二个问题是 pi 看不见脚本做了什么。脚本里 330 多次调用,在 pi 看来只是一条 bash: node analyze.mjs。如果装了权限扩展,它能做的只有对整条命令放行或拦截;脚本里某一次调用是读还是写、要不要让用户确认,它管不到。TUI 里也只显示这一次 bash 调用。
还有一个小问题是中间结果放在哪里。Earendil 的例子里,模型把 167 个 issue 的判断结果存了下来,后面想细看某一个,不用重新拉数据。用 bash 只能写进文件,而文件不属于会话,会话分叉或回退时,文件不会跟着回退。
我也想过给 bash 开个口子:pi 提供一个命令行入口,脚本通过它调用 pi 的工具。这样凭据不用交出去,走这个入口的调用 pi 也看得见。但脚本仍然是一个完整的进程,它完全可以不走这个入口,自己发网络请求、改文件,pi 的检查只管得到愿意经过它的那些调用。
把这几个问题反过来,就是需要的东西:一个执行模型所写代码的地方,跑在 pi 这一侧,能调用 pi 已经接好的工具,但拿不到凭据;除了 pi 的工具,它碰不到文件系统和网络,每一次对外的操作都要经过 pi;它的状态记在会话里。bash 按设计就是一个能访问整个系统的进程,改不成这样,所以要另做一个工具。
这个工具就是 codemode。它只有一个参数:一段 JavaScript 源码。pi 在自己进程的一个 worker 线程里起一个 QuickJS 虚拟机来执行这段代码,内存上限 256 MB。虚拟机里没有 Node、文件系统、网络和定时器,脚本能碰到的只有全局的 tools 对象,也就是 pi 的其他工具,内置的 read、bash 和所有 MCP 工具都在里面。至于为什么是 JavaScript,Earendil 的解释是,精简的 JS 引擎可以编译成 WASM 随程序分发,隔离程度也够用。
脚本调用 tools.mcp__linear__list_issues(args) 时,真正去执行的是 pi:它把这次调用送进自己的工具管线,参数校验、tool_call 钩子、权限检查都和模型直接调用这个工具时一样,执行完再把结果交回脚本。MCP 工具带着 readOnlyHint、destructiveHint 这类标注,权限扩展可以让读操作直接通过,写操作再让用户确认;每一次调用在 TUI 里单独显示,也记录在这次 codemode 调用的结果上。Jev 通过 models.classify() 调用,用的是会话里已有的凭据,源码在把模型信息交给脚本之前,还专门删掉了可能带凭据的 headers 字段。脚本之间要共享数据,用 store(key, value) 和 load(key):写入的值作为自定义条目记进会话记录,恢复会话、分叉之后还在,每个分支只看到自己路径上写入的值。
脚本拿到结果以后可以循环、并发、过滤、排序,最后用 return 或 console.log 输出,模型只看到脚本的输出。Earendil 的例子里,模型写的脚本先拉 issue 列表,再开 4 个 worker 并发拉评论,每拉到一个就调 Jev 分类,最后排序,只返回汇总。回放里脚本内部一共发生了 330 多次调用(1 次列 issue,167 次列评论,167 次分类),模型拿到的只有十几行:167 个 issue 里 156 个语气中性,11 个轻度不满,以及这 11 个 issue 的编号和标题。
让模型写代码来调工具,这个思路不是 pi 首创。Cloudflare 在 2025 年 9 月的 Code Mode 里把 MCP 工具转成 TypeScript API 让模型写代码调用,Anthropic 11 月的 Code execution with MCP 也是同一个方向,Armin 更早在 8 月就写过一篇,主张 MCP 与其提供几十个工具,不如提供一个能执行代码的工具。Earendil 的文章里也说,Codex 等 harness 的做法一样。
codemode 也替代不了 bash。脚本里本来就能调 tools.bash(),两者是上下两层。改代码、跑测试、用 git 这些本地命令行的工作,还是 bash 合适;codemode 负责编排 pi 自己的工具,尤其是 MCP 工具和分类模型这类凭据在 pi 手里、需要逐次检查的调用。
模型怎么写 codemode 脚本
模型怎么知道脚本里能调什么?看 codemode 工具的描述。pi 会把每个可调用的工具渲染成一段 TypeScript 声明。我用 pi 0.99.1 自带的两个函数 createMcpToolDefinition 和 createCodemodeDescription,渲染了一个假设的 tracker server,两个工具仿照上面的例子,其中 list_issues 没有声明 outputSchema,list_comments 声明了。描述里每个工具是一个小标题加一段声明,下面只摘声明部分,为了好读换了行:
// mcp__tracker__list_issues
declare const tools: {
  mcp__tracker__list_issues(args: {
    limit?: number;
    project: string;
    state?: "open" | "closed";
  }): Promise<CallToolResult>;
};

// mcp__tracker__list_comments
declare const tools: {
  mcp__tracker__list_comments(args: {
    issueId: string;
  }): Promise<CallToolResult<{
    comments?: Array<{ author?: string; body?: string }>;
  }>>;
};
声明前面还有一段固定说明(脚本怎么写、有哪些全局函数),以及 CallToolResult、ContentBlock 这些 MCP 共享类型的定义。模型照着这些声明写脚本,比如找出评论超过 20 条的 issue:
const r = await tools.mcp__tracker__list_issues({
  project: "pi",
  state: "open",
});
// list_issues 没有 outputSchema,只能从文本里找出编号
const ids = r.content[0].text.match(/PI-\d+/g);
const cs = await Promise.all(
  ids.map((id) => tools.mcp__tracker__list_comments({ issueId: id })),
);
// list_comments 有 outputSchema,可以直接取字段
return ids.filter((_, k) => {
  const { comments } = cs[k].structuredContent;
  return comments.length > 20;
});两个工具的用法不一样:list_issues 的结果是一段文本,脚本只能用正则去找编号;list_comments 的结果有类型,脚本直接取 comments。这个差别第四节还会用到。
工具一多,描述也会变长,所以声明有预算:默认 3000 token,按 4 个字符算 1 个 token 估算,可以用 codemode.inlineBudget 调。超出预算时,各个 server 轮流放进自己剩下的工具里最短的那个,放不下的 server 就停止,源码注释说这是照着 OpenCode 的做法。每个 server 至少会列出名字和工具总数,描述会注明 PARTIAL - N of M shown。没列出来的工具,脚本里可以用 searchTools(query) 按 BM25 搜索,用 describeTool(name) 取声明。
返回值分两种情况。模型直接调用 MCP 工具时,超过 20KB 的文本会去掉中间一段,只留开头和结尾,全文存到临时文件,这个格式照搬的 Codex。脚本里拿到的是对象:MCP 工具返回完整的 CallToolResult,不截断,由脚本自己过滤;连 tools.bash() 返回的都是 { output, exit_code, ... } 这样的结构。脚本的输出默认上限是 10000 token。
tool_search
deferred 这一档交给 tool_search。它和 Claude Code 的 Tool Search 思路相同:工具定义先不发给模型,模型需要时先搜,搜到的工具从下一次模型调用起才声明,然后直接调用,不经过 codemode。排序和 searchTools() 共用一个 BM25 实现,参与搜索的文本是工具名、描述、参数名和参数描述,以及 server 的名字和说明。加载操作会记进会话,在这条分支上一直有效。
两个工具能碰到的工具是同一批:exposure 不是 direct 或 hidden 的,脚本都能调,tool_search 也都能加载。
Jev
Jev 是 TypeSafe 在 9 月 15 日发布的分类模型。它不生成文本,只回答带类型的问题:从几个选项里选一个,判断是或否,或者打分,答案带概率。pi 把它放进了 codemode 的 models 对象,脚本里用 models.classify(model, { state, questions }) 调用,每个脚本同时最多跑 4 个。上面例子里判断情绪的就是它。分类模型不出现在 /model 里,模型只能通过 codemode 用到它。
回到第二节的三条批评:
- 定义占上下文:默认的
codemode下,MCP 工具不进工具声明,只在 codemode 描述里占一段有预算的 TypeScript 声明;大的 server 可以设成codemode-deferred或deferred,用到时才加载。 - 结果要经过上下文:脚本里的调用结果不进上下文,只有脚本的输出进。
- 不好改:
toolExposure可以藏掉不想要的工具,输出格式不合适,也可以在脚本里改写。
pi 没有收回当初的批评。它在 MCP 和模型之间加了一层代码,三条批评都由这一层来应对。
四、Earendil 给的理由
Earendil 的文章先承认,MCP 这一年变了很多,但光凭这一点,不足以把它放进核心。pi 有扩展系统,MCP 完全可以做成扩展,社区早就有 pi-mcp-adapter。那为什么还要放进核心?
回答这个问题的是 “MCP in a Modern LLM” 那一节,但它的顺序有点绕:开头问的是 “为什么不只做 codemode、不做 MCP”,接着讲 pi 的工具系统缺元数据,普通的 MCP 扩展因此做不好,最后才说他们本可以只把元数据补上、让 MCP 继续交给扩展去做。中间省掉了几步,我按自己的理解补上。
先想一个 MCP 扩展要做好需要什么。第二节那三条批评里,前两条说的都是 MCP 工具不该原样声明给模型:工具太多,定义占上下文;结果太大,每次都要经过上下文。第三节里 pi 的办法是给工具两种新的状态:deferred,先不声明,搜到了再声明;codemode,不声明给模型,只让 codemode 脚本调用,结果留在脚本里。一个 MCP 扩展想这样接入 MCP 工具,宿主的工具系统就得能表达这两种状态,还得允许一个工具(codemode)在执行时去调用另一个工具。原文说 “普通的 MCP 扩展从 pi 的工具系统里拿不到足够的元数据”,指的就是旧的工具系统表达不了这些。
这一点可以在源码里核实。0.99.0 的上一个版本是 0.87.1,我把它从 npm 上拉下来对照了一下。
0.87.1 里,扩展注册工具用的 ToolDefinition 没有 exposure、outputSchema、namespace、annotations、prepareLoadout 这些字段,扩展 API 里和工具有关的只有 registerTool、getActiveTools、setActiveTools、getAllTools 四个。agent 循环里有一段注释写得很清楚:活跃工具就是运行时能执行的工具,每次请求前,发给模型的工具声明会同步成和活跃工具完全一致。模型要是调了一个不在活跃表里的工具,只会拿到 Tool xxx not found。工具执行时拿到的上下文里也没有 executeTool(),一个工具没法经过 pi 的工具管线去调另一个工具。
也就是说,在 0.87.1 里 “能调用” 和 “声明给模型” 是同一件事,扩展能做的就是把工具放进或移出活跃表。我写 pi-question 时在非 TUI 模式下把工具摘掉,用的就是这个。deferred 靠这个还能凑出来:写一个搜索工具,用 getAllTools() 搜,搜到后用 setActiveTools() 把目标工具加进活跃表,下一轮它就声明给模型了。codemode 要的 “能调用,但不声明” 就做不到。硬要做,只能在 before_provider_request 里按各家提供方的格式改写请求体,把声明删掉,而脚本里的调用仍然没有管线可走。
社区的 pi-mcp-adapter 当时的办法是绕开 pi 的工具系统:只注册一个叫 mcp 的代理工具,模型用 mcp({ search: "screenshot" }) 搜工具,再用 mcp({ tool, args }) 调用,连接 server、调用工具都在扩展内部完成。这样省了上下文,但在 pi 看来,所有 MCP 调用都是同一个 mcp 工具的调用,权限扩展看到的只有这一个工具名。9 月 24 日有人问 Armin,说他的 agent 认为用 pi 现有的 API 实现 codemode 要做不少 monkeypatch;Armin 回复说他们正在把 codemode 做成核心能力。
所以 0.99.0 先改的是工具系统。agent 循环本身没动,模型直接调用时仍然只能调活跃工具;变化在它上面一层:会话里多了一份 “可调用工具” 名单,包括活跃的 direct 工具,加上所有 codemode 和 deferred 工具。ctx.executeTool() 按这份名单找工具,调用走和模型直接调用同一条管线,经过同样的钩子,调用记录挂在发起它的那次工具调用的结果上。扩展这边,changelog 里加了一组 API:exposure(direct、model-only、codemode、deferred、hidden)、namespace、annotations、outputSchema 和 structuredContent、prepareLoadout(),以及前面说的 ctx.executeTool()。这些都不是 MCP 专用的,任何扩展注册的工具都能用。codemode 自己就是用这套 API 写的:它的 exposure 是 model-only(脚本里不能再调 codemode),在 prepareLoadout() 里生成第三节那段描述。
到这里,原文开头那个问题才说得通。工具系统改完以后,codemode 和 MCP 其实是两件独立的事:codemode 是编排工具的一层,能调 read、bash、Jev,不接 MCP 也能单独打开;MCP 是工具的来源,照样可以留给扩展去做,扩展现在也能用上 exposure 这些元数据了。原文也承认,他们本可以只把元数据接好,让 MCP 扩展做得更好。他们还是把 MCP 放进了核心,给了两个理由:一是他们认为 MCP 配上 codemode,能解决 MCP 以往的不少问题,也就是第三节对照过的那三条批评;二是想影响一个东西,最好的办法是接纳它,他们想参与 MCP 的讨论,让它在 pi 这样的小型 harness 里也好用。
从 API 的角度看,MCP 也是这套新 API 最合适的第一个用户。MCP 工具本来就有 namespace(server 名),有 annotations(readOnlyHint、destructiveHint 等,pi 会把它们交给权限扩展判断哪些调用需要确认),有可选的 outputSchema,新 API 正好全用上。Jev 也一样,它没有单独的入口,靠 codemode 脚本调用。文章里说 pi 需要的东西和 MCP 需要的东西很像,都是一个可以放手使用的解释器沙箱,指的就是这层关系。
接纳归接纳,他们对 MCP 的问题也说得很直接。他们认为组合仍然是 MCP 最大的问题,codemode 也没有完全解决,但这更多是现有 server 的问题:很多 server 是为 “把工具全塞进上下文” 的 harness 写的,为了省 token 返回文本。他们希望 MCP 更接近 OpenAPI 加上智能的工具发现,工具返回结构化数据,靠文档和描述被找到。
这就要回到第三节那个脚本。脚本里用正则找编号的那一行,就是因为 list_issues 没有声明 outputSchema,返回类型只是笼统的 Promise<CallToolResult>,issue 列表在 content[0].text 里,是一张 markdown 表格,编号、标题、状态都得自己从文本里解析。list_comments 声明了 outputSchema,脚本才能直接对 structuredContent.comments 做循环。
0.99.0 发布前三天,Mario 发过一条:对多数 MCP server 来说,codemode 完全没用,因为它们返回的就是非结构化数据。他认为规范应该让方法返回两个通道,一个是给模型看的非结构化内容,一个是给程序用的结构化数据。MCP 的联合作者 David Soria Parra 在下面回复同意,说希望下一版能解决;眼下的变通办法是把非结构化输出交给一个又快又便宜的模型,转换成需要的类型,当然这并不理想。
MCP 从 2025-06-18 版起就有 outputSchema 和 structuredContent,但规范建议返回结构化内容的工具,同时在 TextContent 里放一份序列化的 JSON,为了兼容老客户端。这样两个通道装的是同一份数据,Mario 想要的是文本通道可以专门写给模型看。更常见的情况是他抱怨的那种:server 只返回文本,连结构化的那一份都没有。
Armin 在 9 月 24 日那条回复的后半句也说了:别对 codemode 期望太高,它现在好坏参半。
这样 pi 的立场就清楚了:接了 MCP,但默认用 codemode 包起来;codemode 能发挥多大作用,又取决于 server 返不返回结构化数据。
五、MCP 的规范在变
Earendil 说 “今天的 MCP 和一年前的不一样”,最大的变化是 7 月 28 日发布的 2026-07-28 版规范。
 The 2026-07-28 SpecificationThe 2026-07-28 Model Context Protocol specification is out, bringing a stateless protocol core, Multi Round-Trip Requests, header-based routing, cacheable list results, authorization hardening, a formal extensions framework, and updated Tier 1 SDKs.
这一版把 MCP 从双向、有状态的协议改成了请求/响应式的无状态协议:
- 去掉了
initialize/initialized握手和Mcp-Session-Id头。每个请求在_meta里自带协议版本、客户端信息和能力声明;想提前知道 server 的能力,可以调新增的server/discover,但不是必需的。任何请求都可以打到负载均衡后面的任何一个实例上,不需要共享存储。 - server 向客户端发起的请求(elicitation、sampling、roots)原来需要一条一直开着的流,现在改成多轮请求(MRTR):server 返回
resultType: "input_required"和它要问的内容,客户端带上答案重发原来的请求。 - HTTP 请求必须带
Mcp-Method和Mcp-Name头,网关、限流、WAF 不用解析 JSON body 就能按方法和工具名路由、计量。 tools/list这类列表结果带上ttlMs和cacheScope,顺序固定,客户端可以缓存工具目录,重连之后上游的 prompt cache 也能保持稳定。- 授权方面,Dynamic Client Registration 正式弃用,改用 Client ID Metadata Documents。Roots、Sampling、Logging 标为弃用,至少保留 12 个月。Tasks 移进扩展。
去掉会话之后,状态怎么办?规范的建议是:需要跨调用保持状态时,让工具返回一个显式的句柄,模型在后续调用里把它当参数传回去。他们认为这比藏在传输层里的会话更好用,因为模型看得见这个句柄,可以在工具之间传递。
第二节提到 Mario 说过,有状态的工具用 MCP 写更方便,因为 MCP server 默认有状态。新规范把这个前提拿掉了,状态的传法变得和 CLI 一样:terminalcp 的 CLI 版就是启动时起一个名字,之后每条命令带上这个名字。
这次改动主要解决谁的问题,看发布文章里合作方的评语就知道。AWS、Cloudflare、Google Cloud、Netlify 等公司说的几乎都是同一件事:部署 MCP server 不用再管会话,可以跑在普通的无状态 HTTP 基础设施上。Supabase 说得更具体:他们的 MCP 一直是无状态运行的,所以之前没法支持 elicitation;有了 MRTR,工具才能在动手之前先让用户确认,比如创建新项目前确认费用,执行会删除数据的查询前确认一次。
对坐在 agent 前面的用户来说,无状态本身不省 token。和模型直接相关的只有两处:列表结果顺序固定、可以缓存,工具定义不会因为重连而变化,prompt cache 更稳;状态句柄放在参数里,模型看得见。其他的收益是间接的,remote server 更容易部署和扩容,连接也不会因为会话过期而失败。
还有一个细节。pi 0.99.1 的 MCP 客户端是自己写的(@earendil-works/pi-mcp,不依赖官方 SDK),里面的 LATEST_PROTOCOL_VERSION 是 2025-11-25,连接时仍然发 initialize,HTTP 传输也还在收发 Mcp-Session-Id;OAuth 按文档走的也是新规范已经弃用的 Dynamic Client Registration。也就是说,pi 这次接入的是上一版的 MCP。Earendil 说的 “MCP 变了” 对这次决定的影响有限,主要的理由在客户端这一侧,也就是 codemode 和工具的延迟加载。
六、Thariq:多数集成用 MCP 比 CLI 好
9 月 15 日,Claude Code 团队的 Thariq 发了一条,说他没想到事情会这样发展,但他现在认为,对多数集成来说 MCP 比 CLI 更好。理由是模型调用工具的能力强了很多,工具可以延迟加载,MCP 现在也是无状态的了。需要组合、过滤数据的话,就给 MCP 工具加 query 这类参数。
有人在下面问,MCP 的主要问题不是占上下文吗?Thariq 回答说,延迟加载就是为这个准备的,它相当于 MCP 的渐进式披露,和模型要先调一次 CLI 才能拿到全部参数是一个道理。也有人追问多数 MCP 客户端到底支不支持延迟加载,他觉得各家支持得不一致,server 作者很难围绕这个功能来设计工具。第二天 Thariq 又补了一条:如果目标只是可靠地调用工具,bash 已经不是唯一需要的东西了;涉及生成代码、执行代码的工作,沙箱加 bash 仍然合适。他在下面还举了个例子:存数据的时候,你真正想要的是一个文件系统,还是一个数据库的 API?
这条推文下面的讨论很多。
Rhys Sullivan 在原帖下面回复,说他对 MCP 剩下的唯一不满是没法把本地文件的数据直接喂给工具,这件事 CLI 做得更好。CLI 可以 cat file | tool,MCP 工具的参数只能由模型生成出来。除此之外,他觉得 MCP 各方面都比 CLI 强。他随后转发时列了理由:工具目录可以建索引,工具再多也能扩展;不需要跑一个完整的沙箱;所有 MCP 的认证方式一致,不像每个 CLI 各搞一套;能同时登录多个账号;code mode 这类实现能让模型事先知道工具会返回什么,用 token 更省。MCP 之前一直没起来,他认为主要怪客户端:要用一个 MCP 得重启整个客户端,agent 调试 MCP 也不如调试 CLI 熟练。他也承认,有些 MCP 本来就可以只是一份 OpenAPI。最后他说,CLI 和 MCP 说到底都只是工具调用的不同方式,把延迟加载、工具搜索和过滤组合起来,就能做出高效的 harness。
Armin 的回复只谈协议层面:今天的 MCP 比刚出来时好了太多。
Shopify 的 Tobi Lütke 在回复里加了一个前提:这个结论成立的条件是模型能通过某种 REPL 使用 MCP,没有 REPL 的话,bash 和 CLI 本身就充当了 REPL。几天后他又单独发了一条,说 MCP 和 CLI 之争是在错误的层面上讨论。两者只要跑在能保持状态的 REPL 式环境里,效果都很好。CLI 显得更好,是因为 CLI 通常通过 bash 调用,而 bash 加上文件系统恰好是一个有持久状态的 REPL。这不是 MCP 本身的缺陷,只说明 harness 要做得更好。他列了目前最好的几种 REPL:bash 加文件系统、Jupyter kernel、基于 QuickJS 的 codemode。
把 Thariq 和 pi 的做法放在一起看,两者对 “组合” 这件事给出了不同的位置。Thariq 的办法放在 server 端:想要其中几条数据,就让工具接受 query 参数,在 server 里过滤完再返回。pi 的办法放在客户端:server 返回完整结果,脚本在沙箱里过滤、合并,只把结论交给模型。前者要求 server 作者预先想到调用方会怎么过滤;后者要求 server 返回结构化数据,否则脚本也只能对着一段文本做字符串处理。Rhys 说 code mode 能让模型事先知道工具会返回什么,前提也是 server 声明了 outputSchema,否则声明里只有一个笼统的 CallToolResult。两种办法都要 server 作者多做一些事。
七、回头看
回到 Mario 那三条批评。定义占上下文,现在靠宿主的延迟加载解决,Claude Code 有 Tool Search,pi 有 deferred 和 codemode 的声明预算。结果占上下文,靠宿主提供的代码层,或者 server 提供的过滤参数。难改这一条,在 codemode 里算是部分解决了,输出不合适,脚本可以自己改写。这些都不是协议解决的。协议这一年做的无状态、缓存提示、授权加固,解决的主要是 server 怎么部署、怎么扩容、怎么鉴权。
Mario 一年前说协议只是管道,这句话现在看依然成立。变化发生在管道两头:宿主不再把工具一股脑声明给模型,模型调用工具的能力也强了。Thariq 觉得 MCP 更好,pi 把 MCP 做进核心,都建立在这两头的变化上。
至于 pi,它这次做进核心的东西里,分量最重的是 exposure 这套工具元数据和 codemode,MCP 是第一个用上它们的。MCP 在 codemode 里能好用到什么程度,要看 server 什么时候开始认真声明 outputSchema、返回结构化数据。